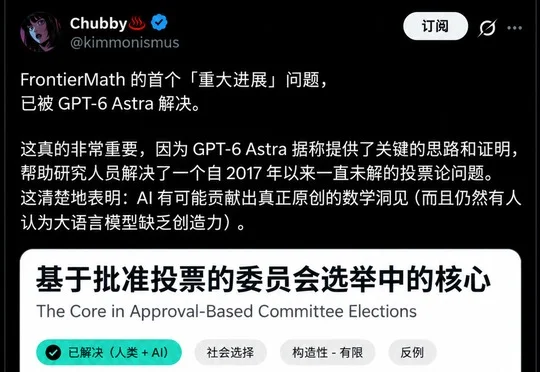
首次!GPT-6 Astra破解「重大进展」级难题,数学家沦为提示词工具人
首次!GPT-6 Astra破解「重大进展」级难题,数学家沦为提示词工具人GPT-6 Astra联合三位人类研究员首次攻克FrontierMath基准测试中一道自2017年悬而未决的「重大进展」级数学难题,证明批准式委员会选举中「核」永远不为空,并创造性地提出基于「调和熵」的新型投票规则及多项式时间算法。
来自主题: AI资讯
9760 点击 2026-09-20 15:13

 搜索
GPT-6 Astra联合三位人类研究员首次攻克FrontierMath基准测试中一道自2017年悬而未决的「重大进展」级数学难题,证明批准式委员会选举中「核」永远不为空,并创造性地提出基于「调和熵」的新型投票规则及多项式时间算法。

OpenAI的GPT-6 Astra攻破了FrontierMath Tier 4最后一道难题,使该研究级数学测试被Epoch AI正式宣布饱和,所有题目均已至少被AI成功解出过一次。
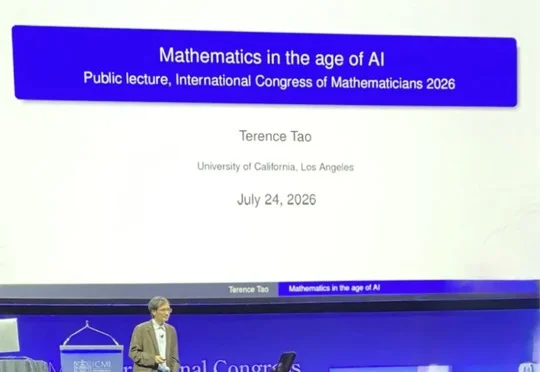
在Epoch AI与曼彻斯特大学发布的FrontierMath Erdős基准测试中,GPT-6 Astra以3%得分率成为唯一非零分模型并解开5道Erdős难题,而GPT-5.6 Sol、GPT-5.5、Fable 5.1与Claude Fable 5均交白卷。
Epoch AI年终大盘点来了!出乎意料的是,AI没有停滞,反而变快了。
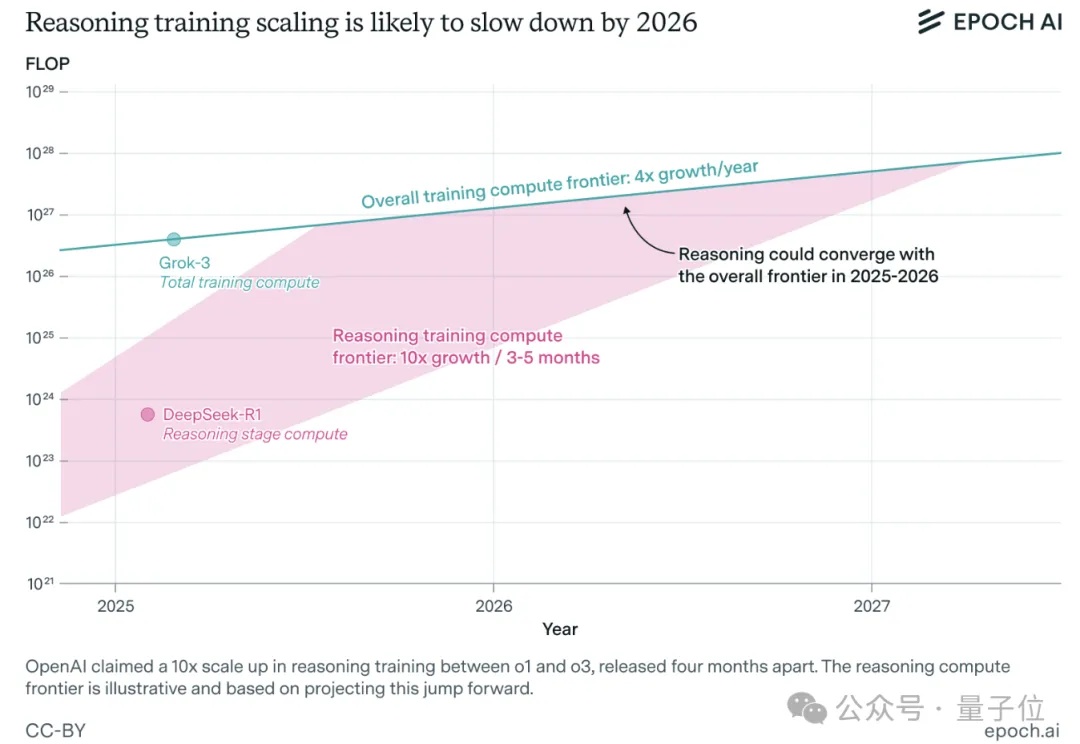
一年之内,大模型推理训练可能就会撞墙。
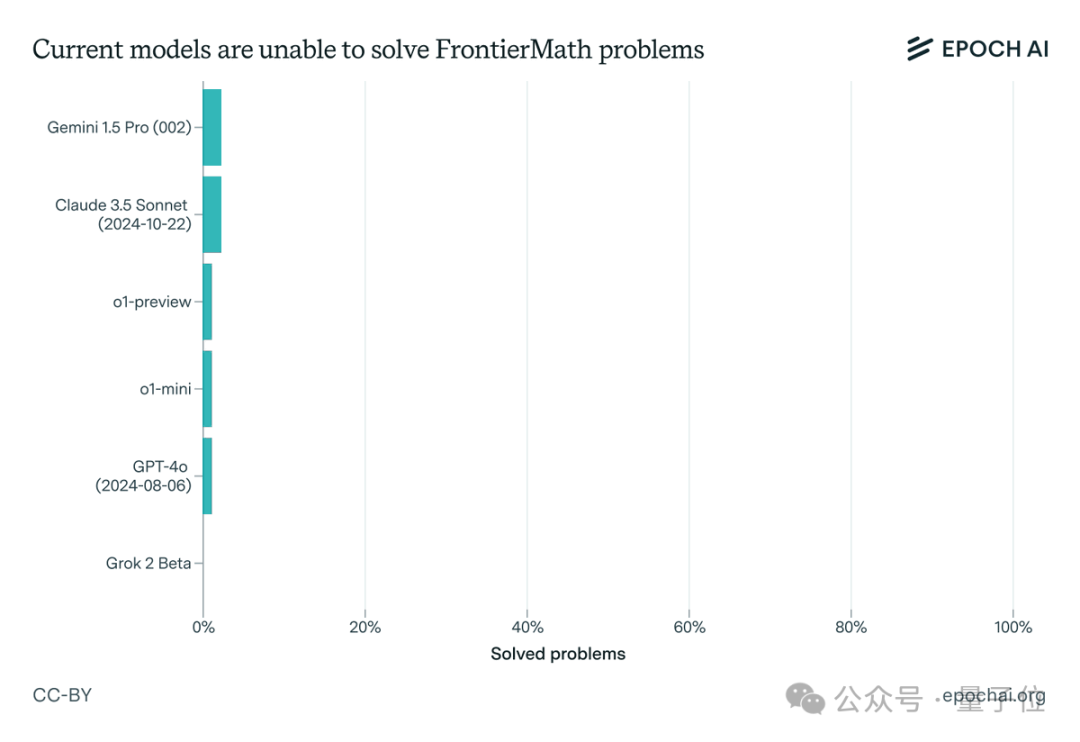
让大模型集体吃瘪,数学题正确率通通不到2%!

Epoch AI推出数学基准FrontierMath,目前前沿模型测试成功率均低于2%!OpenAI研究科学家Noam Brown说道:「我喜欢看到新评估的前沿模型通过率如此之低。这种感觉就像一觉醒来,外面是一片崭新的雪地,完全没有人迹。」或许,FrontierMath测试成功率突破的那一天,会是AI发展过程中一个全新的里程碑。
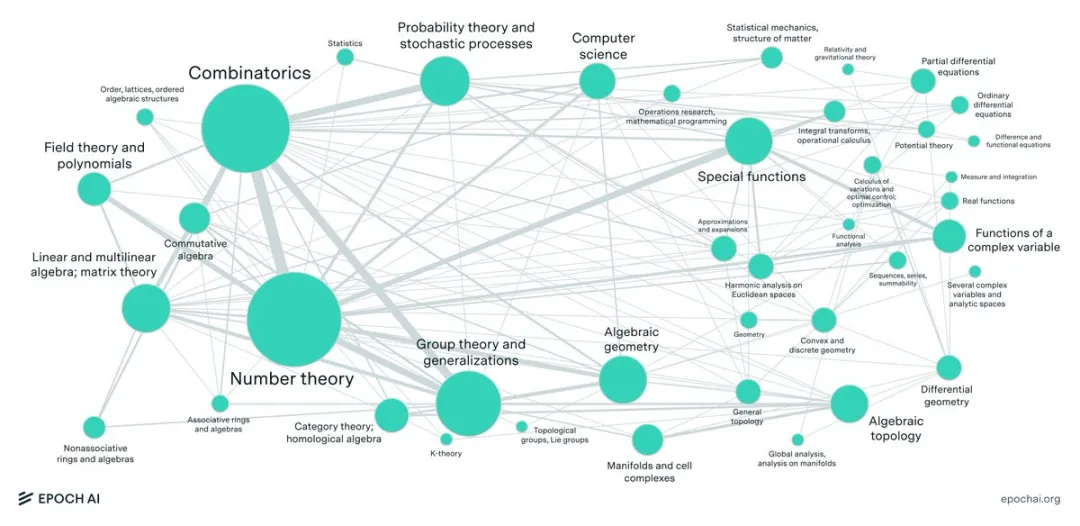
大型语言模型(LLM)最近在各种数学benchmark上疯狂刷分,动辄90%以上的正确率,搞得好像要统治数学界一样。然而,Epoch AI看不下去了,联手60多位顶尖数学家,憋了个大招——FrontierMath,一个专治LLM各种不服的全新数学推理测试!结果惨不忍睹,LLM集体“翻车”,正确率竟然不到2%!